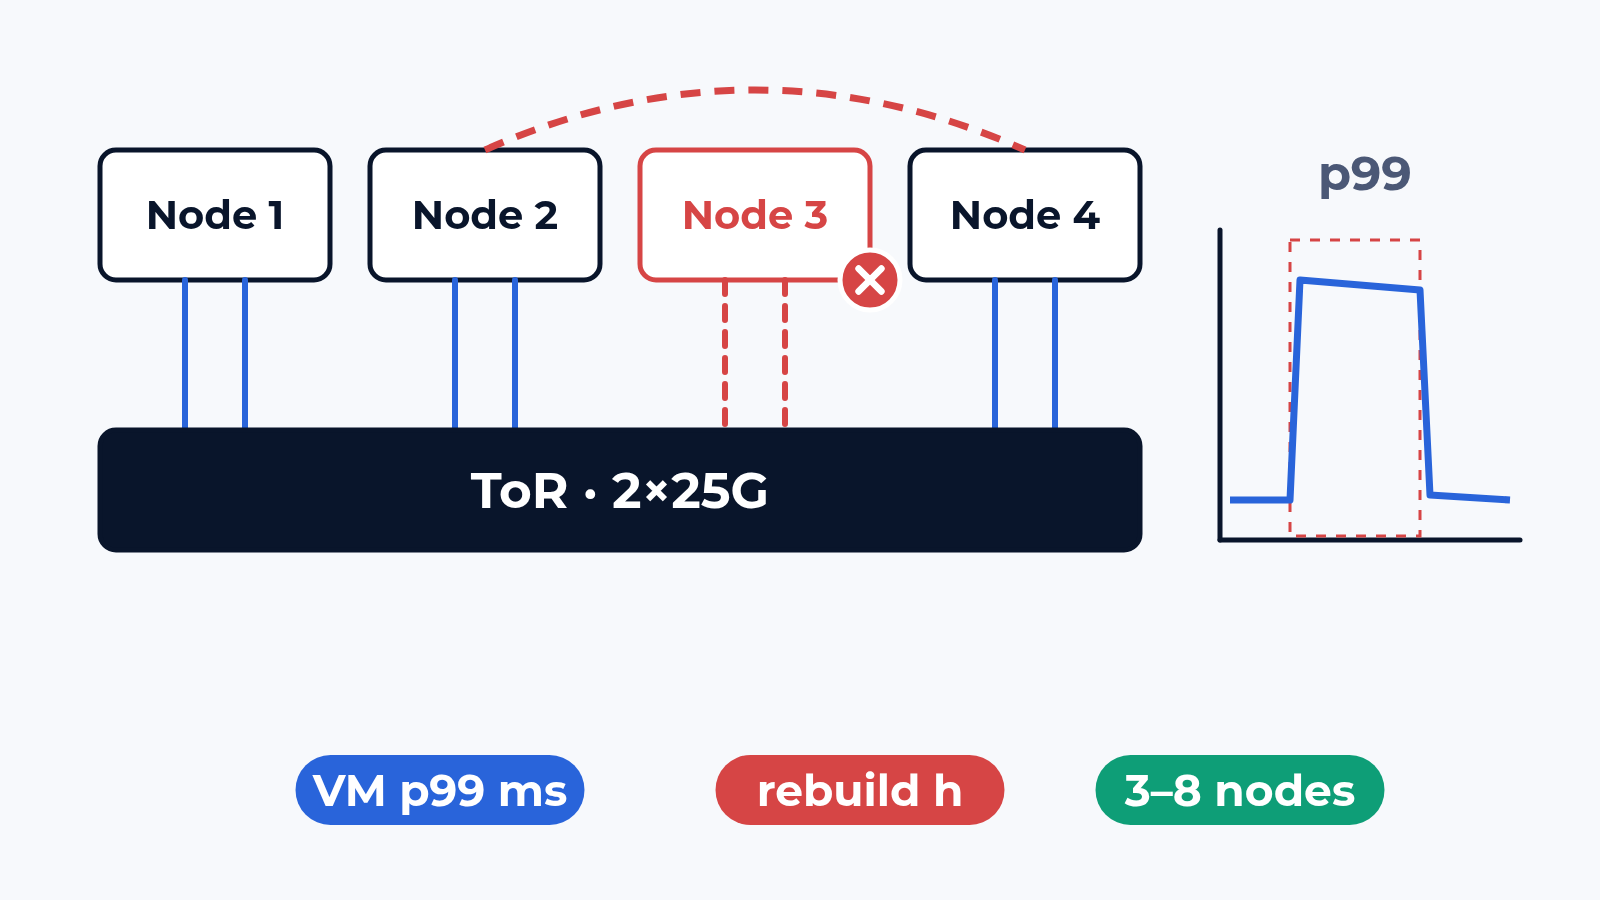
Сайзинг HCI отвечает на один вопрос: сколько VM поместится на 4 узла, если один держать в резерве. Считают его на здоровом кластере. Заказчик читает «N+1» и ждет, что отказ узла отнимет четверть мощности. На деле оставшиеся узлы восстанавливают потерянные копии (rebuild) через те же uplink 25G, по которым идут трафик VM и каждая реплицируемая запись. Мы меряем два числа: latency p99 ввода-вывода VM через каждое событие и время, за которое данные снова полностью защищены.
Стенд
Кластер ваш: от 3 до 8 узлов в стойке или программная платформа на гипервизоре лаборатории. Каждый узел получает 2 uplink по 25G (breakout с портов 100G) к паре ToR с вашей выгрузкой конфигурации: VLAN для VM, хранения, live migration и управления, MTU, LACP, QoS map. Слой хранения работает так, как вы его планируете: фактор репликации или erasure coding, приоритет rebuild, домены отказа.
Нагрузочные VM на каждом узле гоняют ваш профиль ввода-вывода: размеры блоков, соотношение чтения и записи и глубину очереди из статистики вашей нагрузки, на наборе данных, заполненном до того уровня, который вы ждете через год. Порты генератора кладут трафик приложений на те же uplink. Latency пишем по каждой VM, счетчики коммутатора по портам и очередям, и трафик между узлами виден отдельно от трафика VM.
Что проверяем
- Базовая линия: latency p50 и p99 ввода-вывода VM по размеру блока на здоровом кластере, число VM растет, пока p99 не выйдет за ваш критерий
- East-west: трафик репликации и трафик VM по каждому uplink и число VM, при котором линк 25G упирается раньше дисков
- Отказ узла: узел выключаем при идущем вводе-выводе; остановка по каждой VM от последней завершенной операции до первой вернувшейся и момент, когда VM этого узла снова работают на других
- Rebuild: время до восстановления всех копий и p99 VM на всем его протяжении, с приоритетом rebuild по вашему плану и на шаг ниже
- Resync: узел возвращается посреди rebuild; сколько длится досинхронизация и что она делает с задержкой
- Режим обслуживания и rolling upgrade: узел за узлом, VM уходят через live migration, resync перед следующим узлом, общее окно
- Отказ uplink: гасим один линк 25G, один порт NIC или один ToR; остановка и то, не примет ли кластер это за потерю узла
HCI – один из 5 классов устройств на странице хранилищ; сеть до внешнего массива разобрана в посте как мы тестируем сети хранения.
Что обычно ломается
Rebuild на uplink с трафиком VM. В типовом проекте кластер из 4 узлов теряет узел, и rebuild стартует на полной скорости по тем же 2×25G. Latency записи VM на p99 растет с 3 мс до 45 мс и держится так все 2 ч 40 мин rebuild; VM с базами данных ловят таймауты задолго до того, как данные в безопасности. Когда хранение выделено в свой класс на ToR, а приоритет rebuild снижен на шаг, p99 остается ниже 9 мс, rebuild занимает 3 ч 50 мин. Владелец выбирает вариант, имея на столе обе цифры.
Отказ uplink, похожий на потерю узла. VLAN хранения настроен на MTU 9000 на хостах и их портах коммутатора, а линк между двумя ToR остался на 1500. Все работает, пока один uplink не падает и трафик хранения не идет через этот линк. Маленькие heartbeat проходят, большие кадры репликации нет, и по таймауту кластер объявляет копии здорового узла потерянными и восстанавливает их впустую. Одна строка в конфигурации коммутатора, найденная в первом же сценарии отказа.
Rolling upgrade длиннее окна. В плане 30 минут на узел. Каждый узел – это переезд VM, обновление, затем resync всего, что записали за это время, и следующий узел ждет его конца. На 6 узлах под рабочей нагрузкой окно в типовом проекте выросло с плановых 3 часов до 7. Во время каждого resync у данных на одну копию меньше, и платформенной команде нужно видеть этот риск в часах.
Что в отчете
Latency p50 и p99 ввода-вывода VM по размеру блока и числу VM на здоровом кластере и кривой через каждое событие. Остановка по каждой VM для каждого отказа. Время rebuild, resync и обновления по событиям и настройкам. Трафик и потери по uplink и очередям, хранение отдельно от трафика VM. Выгрузки конфигурации узлов и пары ToR для каждого прогона, со строкой конфигурации за каждым непройденным критерием.
С чего начать
Пришлите нам число узлов, платформу HCI и схему коммутаторов. Мы ответим черновиком тест-плана: пункты проверки, схема стенда и сроки. Отчет остается у вас, его можно показать вендору. Напишите нам или посмотрите, что еще умеет стенд.
 Alexander Zemskov
4 мин чтения