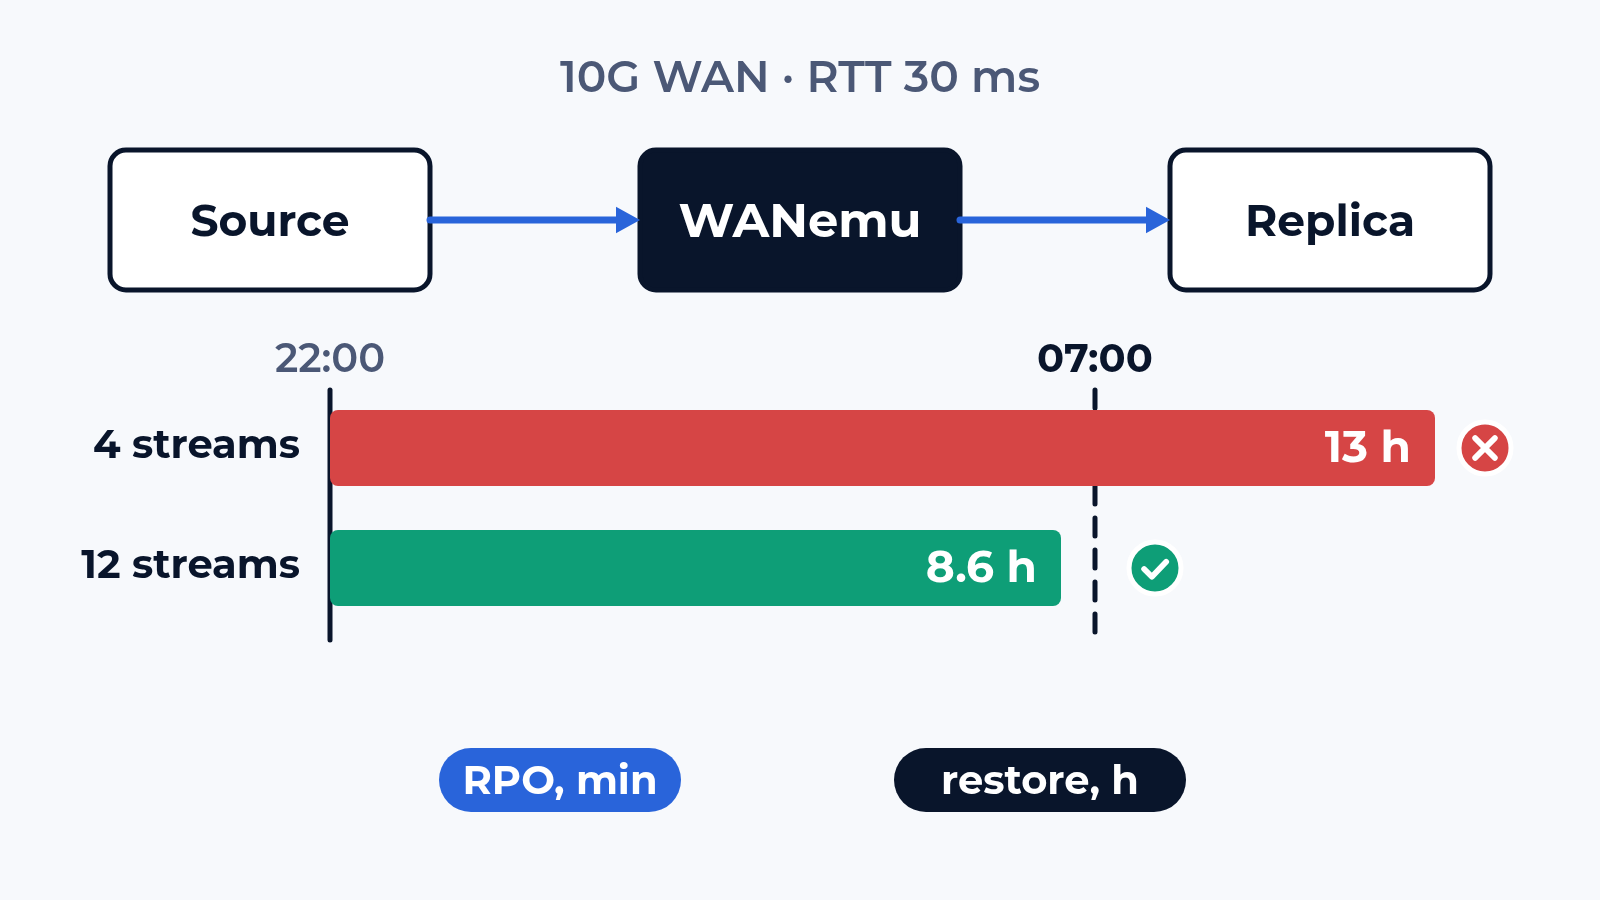
В расчете сайзинга объем делят на канал: 20 TB через WAN 10G дают 4,4 часа, окно с 22:00 до 07:00 длится 9 часов, запас вроде бы двойной. На 30 мс RTT с потерями реального канала продукт бэкапа с настройками по умолчанию открывает несколько потоков, каждый упирается в свое окно TCP, и в типовом проекте те же 20 TB шли 13 часов. Мы меряем бэкап и репликацию на профиле вашего WAN: закончится ли задание до утра, на сколько минут отстает реплика и сколько длится восстановление.
Стенд
Ваш WAN попадает на стенд как профиль: задержка, jitter, потери и ограничение полосы с очередью, по каждому направлению, из библиотеки или по замерам вашего собственного канала. Профиль применяет наш эмулятор WANemu, сейчас в бете на линках 1G и 10G стенда, а в отчете примененные и измеренные значения стоят рядом.
С одной стороны стоят хосты-источники с тестовым набором данных по вашему профилю: размеры файлов, суточный объем изменений, сжимаемость. Продукт бэкапа или репликации и его агенты работают на стенде. Приемник – репозиторий в стойке, программное хранилище на хостах стенда или ваша система за выделенным каналом. Порты генератора кладут смесь приложений на тот же канал WAN. Время на тестовом наборе замеряем и экстраполируем на ваши 10–200 TB.
Что проверяем
- Throughput одного потока на вашем RTT и потерях и число потоков, после которого еще один уже не помогает
- Полные и инкрементальные задания: время до последнего байта, записанного на приемнике, против границы вашего окна
- Дедупликация и сжатие: байты в канале против защищаемых байтов для ваших данных и загрузка CPU прокси
- Отставание реплики в минутах при ночном и пиковом темпе изменений и время, за которое оно рассасывается: это ваш реальный RPO
- Задание, запущенное в пик: его throughput и задержка и потери, которые тем временем получают пользователи
- Переключение WAN посреди задания: продолжится ли задание, повторится с контрольной точки или начнется заново
- Восстановление тестового набора через WAN: время до первого рабочего файла и до последнего, с экстраполяцией на объем, который придется поднимать после аварии
На странице хранилищ бэкап через WAN входит в 5 классов устройств. Почему один поток TCP вязнет на большой задержке, рассказано в посте Как мы тестируем TCP throughput; сеть между хостами и массивом разобрана в отдельном посте.
Что обычно ломается
Мало потоков. В проекте из первого абзаца продукт открывал 4 потока, значение по умолчанию, рассчитанное на LAN. Throughput рос с числом потоков до 8 и там вставал: прокси дедупликации сидел на 100 % CPU. С 2 дополнительными vCPU рост продолжился до 12 потоков, и те же 20 TB прошли за 8,6 часа, внутри окна. Канал остался прежним.
RPO держится только ночью. Асинхронная репликация отстает на 1–2 минуты, пока пользователи спят. В утренний пик приложение пишет больше, а по тому же каналу работают пользователи, и в типовом проекте отставание дошло до 35 минут при RPO 15, а потом 3 часа рассасывалось. Дашборд со средним отставанием за сутки все это время показывал приличную цифру.
Переключение, которое репликация не переживает. Основной канал WAN падает, маршрутизация уводит трафик на второй за 40 секунд. У сессии репликации таймаут 30 секунд: она рвется и запускает полную ресинхронизацию тома 2 TB по более медленному каналу. Задание бэкапа на том же переключении продолжается с контрольной точки. Оба поведения задаются настройками продукта, и стенд показывает, какое у вас, раньше настоящей аварии.
Что в отчете
Окно по каждому типу задания против вашей границы, с кривой throughput и числом потоков. Throughput по числу потоков для каждого профиля WAN. Байты в канале против защищаемых байтов и загрузка CPU прокси. Отставание реплики за сутки: пик, время рассасывания, линия вашего RPO. Время восстановления тестового набора с экстраполяцией на полный объем. Каждое переключение с длительностью разрыва и действием задания. По каждому прогону: профиль WAN, примененный и измеренный, настройки продукта, счетчики хостов. После обновления продукта или изменения WAN повторный прогон и сравнение с этим отчетом занимают 3 рабочих дня.
С чего начать
Пришлите нам объем данных, схему WAN между площадками и окно, в которое должно уложиться задание. Мы ответим черновиком тест-плана: пункты проверки, схема стенда и сроки. Отчет остается у вас, его можно показать вендору. Напишите нам или посмотрите, что еще умеет стенд.
 Alexander Zemskov
4 мин чтения