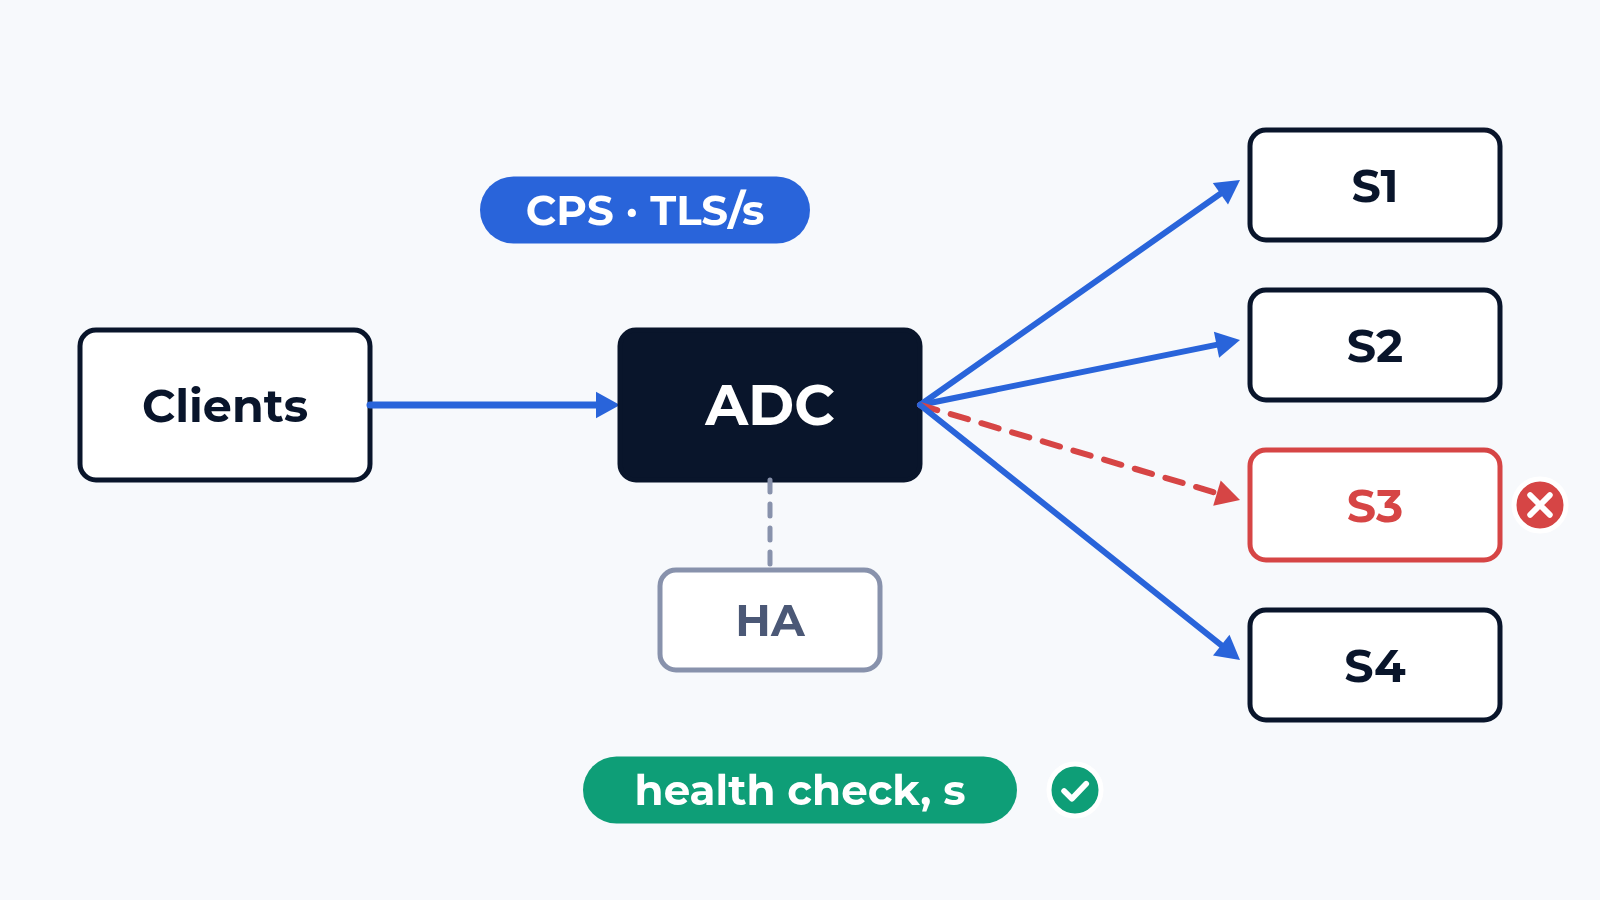
В даташите балансировщика два больших числа: соединения в секунду на L4 и запросы в секунду на L7. Обычно их снимают на маленьких объектах, без TLS, без persistence и со всеми функциями выключенными. В продакшене тот же ADC терминирует TLS, привязывает пользователей к серверам по cookie, переписывает заголовки, сжимает ответы, применяет политику WAF и проверяет здоровье фермы. В 11:00 один сервер зависает. Мы измеряем устройство с этой конфигурацией и считаем пользователей, которые заметили зависание.
Стенд
Аппаратный ADC ставится на стенд CloudLAB, виртуальный запускается как образ на гипервизоре лаборатории или в вашем облачном тенанте. Со стороны клиентов генератор эмулирует пользователей: у каждого свой адрес источника, сессии TCP и TLS, cookie и keep-alive, по HTTP/1.1 и HTTP/2. Со стороны серверов он эмулирует ферму: столько серверов, сколько в вашем пуле, у каждого одинаковый контент, фиксированное время ответа и свои счетчики. Любой сервер можно замедлить, заставить отвечать ошибками или остановить в известную секунду.
Размеры объектов (от 1 КБ до 512 КБ) и состав запросов берутся из ваших логов или из библиотеки приложений нашего генератора трафика; пулы, persistence, правила перезаписи, профиль TLS и политика WAF берутся из выгрузки конфигурации. Stateful-нагрузка доходит до 200 Гбит/с и выше на портах от 1G до 100G.
Что проверяем
- Емкость L4: новые соединения в секунду и одновременные соединения, ступенями до первого отказа в соединении, с CPU и памятью устройства на каждой ступени
- Терминация TLS: handshake в секунду с вашим сертификатом и списком шифров, полные и с возобновлением сессии, плюс повторное шифрование к серверам, если оно у вас включено
- Скорость L7: HTTP-запросы в секунду с включенными persistence, перезаписью заголовков и вашими правилами, keep-alive и HTTP/2 так, как ими пользуются клиенты
- Распределение: запросы и соединения по каждому серверу при выбранном алгоритме и места, где persistence сваливает пользователей на один сервер
- Health check: сервер зависает, отвечает 500 или пропадает в известную секунду; время, за которое пул его выводит, запросы с ошибкой за это время, пользователи, привязанные к нему
- HA-пара: активное устройство падает в пике; время переключения, соединения, которые пережили его, записи persistence и сессии TLS, которые не пережили
- Издержки каждой функции: WAF, сжатие, кэш и правила по контенту включаются по одной, каждая ступень в запросах в секунду и в p99 задержки
Числа по каждому шифру снимаются по методике наших тестов TLS и HTTPS, здесь это одна строка из семи. Ступени как в нагрузочных тестах: шаг 1 000 соединений в секунду, 5 минут на ступень, до первой ошибки.
Что обычно ломается
Health check, который видит только порт. В типичном проекте пул проверяет TCP-порт 443 каждые 5 секунд. Сервер с зависшим приложением соединение все равно принимает и остается в пуле. При 4 серверах и persistence по cookie четверть пользователей продолжает на него попадать и на каждом клике ждет таймаута, пока кто-нибудь не перезапустит приложение. HTTP-проверка страницы статуса со сверкой содержимого выводит сервер за 15 секунд (3 неудачные проверки с интервалом 5 секунд, значения для примера). Проверка порта прошла приемку, потому что на приемке только выдергивали кабель.
Счет за функции. Типичный ADC держит свою скорость L7 на простых правилах и теряет примерно половину, когда политика WAF и сжатие включаются вместе (числа для примера). Сжатие тратит CPU на текстовых страницах и почти ничего на картинках, поэтому результат зависит от вашего микса, а тест на миксе вендора отвечает на другой вопрос. Устройство подбирают по строке, где включено все, что вы собираетесь включить.
Минута после failover. Резервное устройство берет работу примерно за секунду, и соединения с синхронизацией сессий выживают. Кэш сессий TLS и таблицу persistence часто оставляют несинхронизированными. Все клиенты разом делают полный handshake, новое активное устройство рассчитано на возобновление сессий, и p99 держится выше цели 20 секунд (пример). Пользователи теряют свой сервер, а с ним и сессию там, где приложение хранит состояние в памяти. Время failover из даташита покрывает первую секунду, мы записываем следующие 60.
Что в отчете
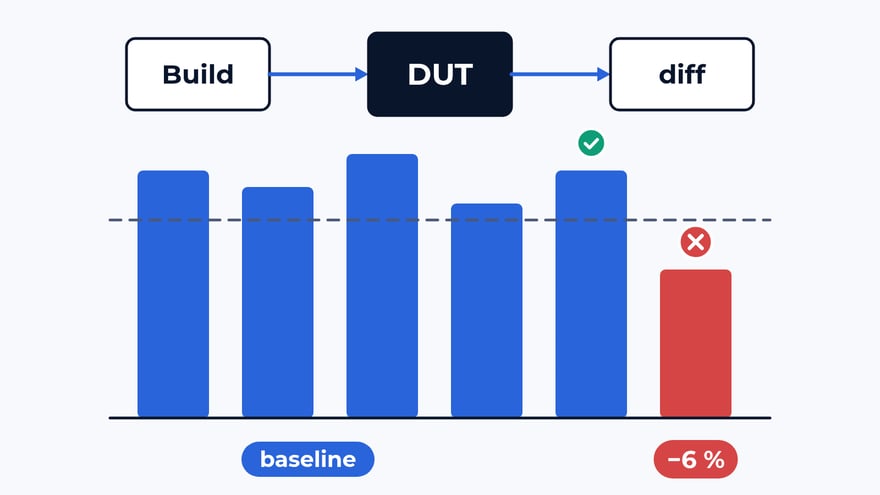
Таблицы по ступеням нагрузки: соединения и handshake в секунду, одновременные соединения, запросы в секунду с p50 и p99, по каждому набору функций. Запросы по каждому серверу, чтобы был виден разброс алгоритма. Таймлайн каждого отказа сервера и каждого failover: секунда события, секунда реакции ADC, запросы с ошибкой и затронутые пользователи между ними. Выгрузка конфигурации, профиль трафика и настройки генератора, чтобы тот же прогон повторился на следующей прошивке или на конкурирующем ADC.
С чего начать
Пришлите нам модель или образ, выгрузку конфигурации и трафик вашего самого нагруженного часа. Мы ответим черновиком тест-плана: пункты проверки, схема стенда и сроки. Отчет остается у вас, его можно показать вендору. Напишите нам или посмотрите, что еще умеет стенд.
 Alexander Zemskov
4 мин чтения