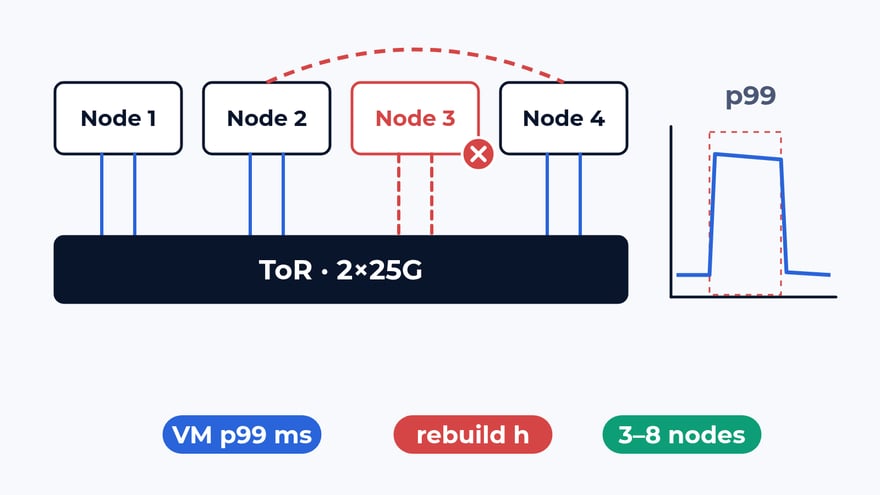
На слайде вендора написано: «failover меньше 50 мс». Обычно это число снято на пустом устройстве: один поток, два линка, таймеры по умолчанию. В продакшене тот же отказ приходится на роутер с 1M маршрутов, на пару межсетевых экранов с миллионами сессий, на ECMP-группу с тысячами потоков, и каждый поток теряет трафик свое время. Это окно потерь мы и измеряем: по каждому потоку, в миллисекундах.
Стенд
Устройство под тестом стоит в стойке CloudLAB на портах 1G, 10G или 100G (400G и быстрее – под проект): пара роутеров или pod leaf-spine, кластер NGFW. Генератор эмулирует окружение: сотни соседей BGP, OSPF и IS-IS с таблицей до 1M маршрутов, пользователей и серверы с 2–20 млн сессий через HA-пару. В каждом потоке есть номера последовательности и метки времени, поэтому генератор видит последний пакет до отказа и первый после него. При постоянной скорости потерянные кадры, деленные на скорость, дают перерыв в мс.
Отказы мы устраиваем намеренно и в известный момент: гасим порт или выдергиваем волокно, останавливаем соседа на эмулированной стороне, выключаем узел, переключаем супервизор, роняем активный член HA-кластера. Таймеры, BFD, хеширование ECMP, LFA и синхронизация сессий берутся из вашего конфига.
Что проверяем
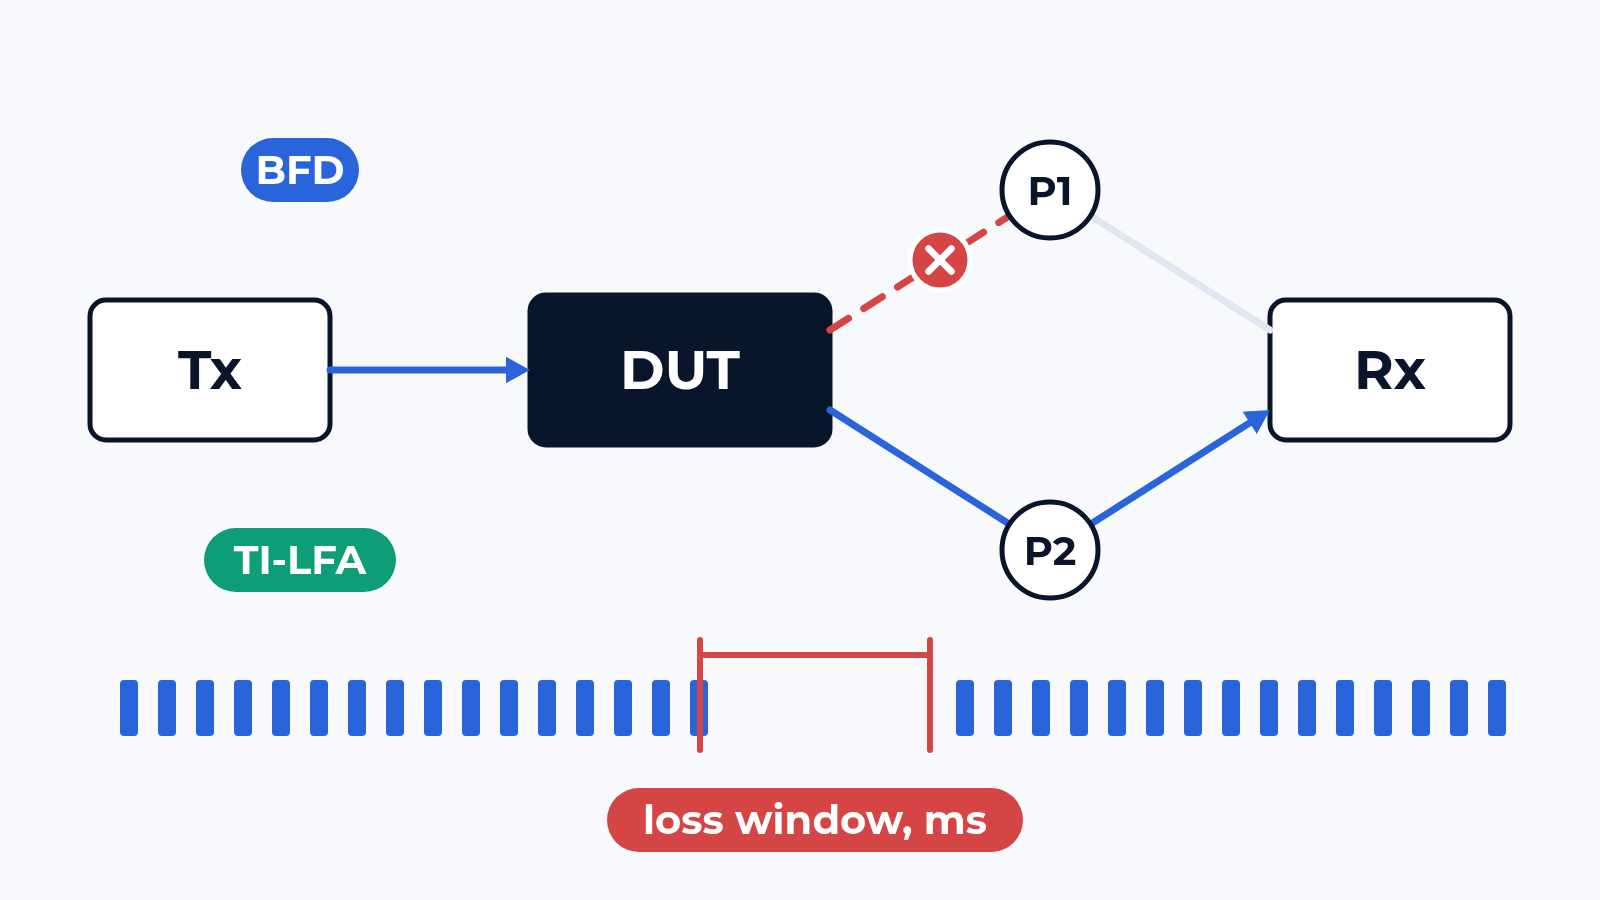
- Отказ линка: один линк падает при полной таблице и трафике на всех портах; разрыв по каждому потоку, худший и медианный, и тот же замер при failback, когда линк возвращается
- Потеря узла или пира: пропадает роутер, спайн или сосед BGP; время до восстановления форвардинга с BFD и без него, на ваших таймерах
- Link flap: порт дергается раз в несколько секунд; сходимость на каждом событии, CPU, churn маршрутов, dampening
- BFD на масштабе: ваш интервал и множитель на 10 сессиях и на сотнях, пока control plane занят установкой маршрутов
- LFA и TI-LFA: защищенные префиксы читаем с устройства, затем меряем реальный перерыв на защищенных и незащищенных префиксах после одного и того же обрыва
- Перехеширование ECMP: из группы выпадает один линк; потери и переупорядочивание на потоках, которые шли через него, и на тех, что его не касались
- Stateful failover: активный межсетевой экран падает с миллионами сессий в работе; секунды до возобновления трафика, сколько сессий сохранилось, сколько пришлось переоткрыть
Часть этого покрывает RFC 2544 тестами system recovery и reset, и мы гоняем их, когда этого требует тендер. Остальные пункты получают критерии прохождения из вашего дизайна, записанные до старта.
Что обычно ломается
Таймеры. Типичная приемка: пара ядра, 1M маршрутов BGP, цель по дизайну 500 мс. Отказ линка останавливает трафик на 1,9 с. Лог показывает BFD, выключенный на одной группе пиров, и hold-таймеры по умолчанию на другой. После настройки BFD и включения prefix-independent convergence повторный прогон дает 180 мс. Число из даташита было правдой про чип и ничего не говорило про конфиг.
Средние. LFA защищает большую часть префиксов в кольце или неполной сетке, а часть оставляет без loop-free резерва. Медианный поток восстанавливается за десятки миллисекунд, худший ждет полной сходимости. У ECMP своя версия: группа теряет 1 линк из 4, хеш пересчитывается, и потоки на 3 здоровых линках тоже переупорядочиваются. Таблица по потокам показывает оба случая, одно число сходимости их прячет.
Сессии. HA-пара синхронизирует таблицу сессий, на слайде обещано переключение меньше чем за 1 с. В одном типичном прогоне с 1 млн сессий оно заняло 1,8 с, после исправления от вендора 0,7 с. Другой частый сюжет: сессии, открытые в последние мгновения перед отказом, еще не дошли до резервного устройства и сбрасываются. На пустой паре не видно ни того, ни другого.
Что в отчете
Таблицу по каждому типу отказа: событие, затронутые потоки или префиксы, перерыв для худшего и медианного потока, failback и полосу прохождения из вашего дизайна рядом с измеренным значением. Для каждого HA failover: секунды до возобновления трафика, сохраненные и сброшенные сессии. Покрытие LFA по префиксам. Выгрузку конфига и настройки эмулированных соседей, чтобы вендор мог повторить любой пункт.
С чего начать
Пришлите нам модели устройств, прошивку, которую планируете запускать, и отказы, которые беспокоят вас больше всего. Мы ответим черновиком тест-плана: пункты проверки, схема стенда и сроки. Отчет остается у вас, его можно показать вендору. Напишите нам или посмотрите, что еще умеет стенд.
 Alexander Zemskov
4 мин чтения