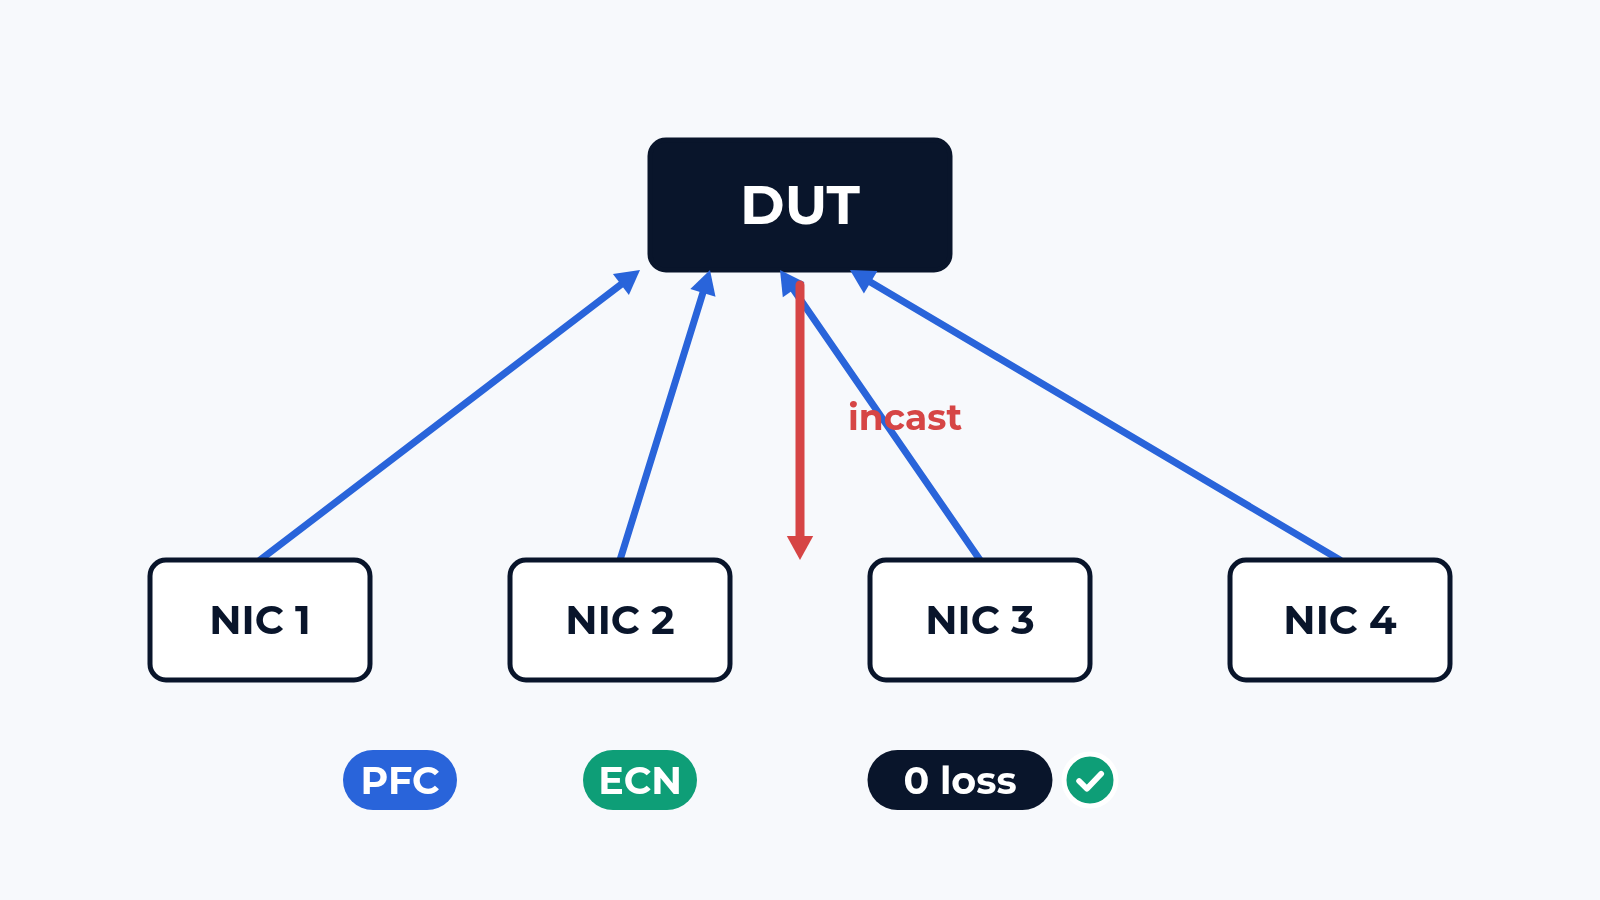
AI կլաստերը ժամանակի մի մասը ծախսում է ցանցին սպասելու վրա։ Մեկ գցված RoCE փաթեթն առաջացնում է go-back-N վերահաղորդում, կոլեկտիվ գործողությունը կանգնում է, և 256 GPU պարապ են մնում, մինչև ամենադանդաղ հոսքը վերականգնվի։ Կոմուտատորի բնութագրում գրված է՝ «lossless Ethernet, PFC, ECN»։ Հարցն այն է, թե ինչ է անում կոմուտատորը, երբ 32 ուղարկող միաժամանակ հարվածում են մեկ ընդունող պորտի, և հենց դա է չափում ստենդը։
Ստենդը
Փորձարկվող սարքը AI կամ պահոցային ֆաբրիկի leaf կամ spine կոմուտատոր է, 100G պորտերով։ Գեներատորը էմուլյացնում է NIC-երը՝ RDMA queue pair-եր, RoCEv2 տրաֆիկ իրական վերնագրերով, PFC pause կադրեր ուղարկված և ստացված, ECN նշաններ կարդացված յուրաքանչյուր փաթեթի համար, և congestion control, որն արձագանքում է այնպես, ինչպես DCQCN-ը։ Incast օրինաչափությունները կառուցվում են այն կոլեկտիվ գործողություններից, որոնք կլաստերը կաշխատեցնի՝ all-reduce, all-to-all, framework-ի հաղորդագրությունների չափերով։
Կոմուտատորն աշխատում է Ձեր buffer պրոֆիլով, Ձեր PFC և ECN շեմերով և Ձեր QoS քարտեզագրմամբ։ Այս կարգավորումներն արդյունքն ավելի են որոշում, քան չիպը, ուստի մենք փորձարկում ենք այն կոնֆիգուրացիան, որը Դուք նախատեսում եք ներդնել։
Ինչ ենք ստուգում
- Անկորուստ աշխատանք incast-ի տակ. 4, 8, 16 և 32 ուղարկող դեպի մեկ ընդունող line rate-ով, կորցրած փաթեթները, եթե կան, և PFC pause կադրերը, որոնք կոմուտատորն ուղարկել է դրան հասնելու համար
- ECN նշագրում. նշագրման արագությունը յուրաքանչյուր հերթի համար կոնֆիգուրացված շեմերի դիմաց, և դրանից բխող ուղարկողի արագությունը՝ որպես կոր ժամանակի ընթացքում
- PFC-ի վարք. pause կադրեր յուրաքանչյուր պորտի և առաջնահերթության համար, pause-ի տևողությունը, head-of-line blocking անկապ պորտերի վրա, PFC փոթորիկներ և watchdog
- Buffer. ընդհանուր buffer-ի օգտագործումը յուրաքանչյուր հերթի համար incast-ի տակ, իրականում պահված headroom-ը հաշվարկվածի դիմաց
- Latency և jitter. յուրաքանչյուր հոսքի համար բեռի տակ, յուրաքանչյուր պերցենտիլի համար, congestion-ով և առանց
- Բեռի բաշխում. ECMP spine-երի միջև GPU խնդրի առաջացրած փոքրաքանակ մեծ հոսքերով, ստացվող անհավասարակշռությունը յուրաքանչյուր կապուղու համար
- Խառը տրաֆիկ. RoCE անկորուստ դասում, պահոցային կամ կառավարման տրաֆիկը կորստով դասում, և արդյոք մեկը վնասում է մյուսին
- Խափանում. spine կապուղու կորուստ կոլեկտիվ գործողության կեսին, ընդհատումը յուրաքանչյուր հոսքի համար և դրա առաջացրած վերահաղորդումները
Ինչն է սովորաբար խափանվում
Headroom-ը։ Buffer պրոֆիլը հաշվարկված էր 100 մ մալուխների համար, իսկ ֆաբրիկն ունի մի քանի 2 կմ կապուղի դահլիճների միջև։ Pause կադրը հասնում է չափազանց ուշ, կոմուտատորը գցում է 40 փաթեթ, յուրաքանչյուրն արժե մեկ go-back-N։ 1 էջ հաշվարկ և 2 ժամ թեստ՝ ամիսներով «խնդիրն անպատճառ դանդաղ է»-ի դիմաց։
Երկրորդ. ECN շեմերը պատճենված են վենդորի ուղեցույցից, որը գրված է այլ ASIC-ի համար։ Նշագրումը սկսվում է չափազանց ուշ, DCQCN-ն արձագանքում է չափազանց ուշ, PFC-ն վերցնում է կառավարումը, և pause-ները տարածվում են 3 hop հետ ֆաբրիկի մեջ։ Ֆաբրիկն անկորուստ է և դանդաղ։ Նշագրման արագության կորը հերթի խորության դիմաց դա ցույց է տալիս մեկ նկարով։
Երրորդ. բեռի բաշխում։ 8 հոսք 4 spine կապուղով, 2-ը հայտնվում են նույն կապուղու վրա, մեկ GPU զույգ աշխատում է կես արագությամբ, և ամբողջ կոլեկտիվ գործողությունը սպասում է դրան։ Տեսանելի է ստենդում 8 էմուլյացված հոսքով, անտեսանելի՝ throughput թեստում 10 000-ով։
Ինչ կա հաշվետվության մեջ
Կորուստների և pause-ների քանակը յուրաքանչյուր incast սցենարի համար։ ECN նշագրման կորը յուրաքանչյուր հերթի համար։ Buffer-ի զբաղվածությունը ժամանակի ընթացքում։ Latency յուրաքանչյուր պերցենտիլի համար։ Բեռի բաշխման աղյուսակը յուրաքանչյուր կապուղու համար։ Ռեսուրսները, կոմուտատորի կոնֆիգուրացիան buffer և QoS պրոֆիլով, էմուլյացված NIC-ի կարգավորումները, firmware-ը և պորտերը։ Բավարար է, որ վենդորը կրկնի յուրաքանչյուր կետ, իսկ Դուք սահմանեք շեմերը մինչև առաջին GPU-ի միացումը։
Որտեղից սկսել
Ուղարկեք մեզ սարքի մոդելը, firmware-ի տարբերակը, որով նախատեսում եք աշխատել, և տոպոլոգիան, որտեղ այն կտեղադրվի։ Մենք պատասխանում ենք թեստի պլանով՝ կետերը, ստենդի սխեման և ժամկետները։ Պլանն անվճար է, հաշվետվությունը մնում է Ձեզ, և Դուք կարող եք այն ցույց տալ վենդորին։ Գրեք մեզ կամ տեսեք, թե էլ ինչ է անում ստենդը։
 Alexander Zemskov
3 րոպե ընթերցում
 Alexander Zemskov
4 րոպե ընթերցում